Unicode和它的朋友们(上)
Author: [麟十一]
Link: [https://mp.weixin.qq.com/s/54cdPxMj2Lg37oLdeDj3xw]
写在前面
原本这一篇是要写“TTF里都有什么”,不过之前在解析TTF的时候我发现文件里所有的汉字都是用Unicode十六进制编码存储的,整个TTF文件从头到尾没有出现过汉字,所以我想先简单写一篇Unicode编码和汉字相转换的文章作为前言,这样下一篇就只需要专心解析TTF了
不过万万没想到,Unicode并没有我想的那么简单,它不是一个单独的个体单独解释Unicode总感觉解释不清楚,所以我最终把这一篇写成了字符编码史,这一篇又称“Unicode和它的100个周边”
1. 位,字节和字符
在计算机中,所有信息都是由1和0组成的二进制数字表示的,每一个0或1就是一个位(bit) ,位是计算机中最基本的单位,8个位构成一个字节(byte) 。而编码 就是一套电脑内的数字 (二/八/十/十六进制等)和字符相对应的规则 。字符通过编码转换成计算机可以识别的数字,这些数字通常使用字节来存储,将字节解码就会得到相应的字符或字符串。

字符串和字节的转换示意图
在Python中可以用encode() 和decode() 两个函数实现字符和编码的转换:
#1. 字符-->字节
char2bytes = '麟'.encode('utf-8')
print(char2bytes) # b'\xe9\xba\x9f'
print(type(char2bytes)) # <class 'bytes'>
#2. 字节-->字符
bytes2char = b'\xe9\xba\x9f'.decode('utf-8')
print(bytes2char) # '麟'
print(type(bytes2char)) # <class 'str'>上面代码中b 代表后面的内容为字节类型 ,\x 代表后面的数字为十六进制 ,可以看到汉字“麟”通过UTF-8编码之后变成了3个字节,字节解码之后又变成了字符串。 由于这篇文章涉及的概念很多,我做了一张图当作目录,这张图涵盖了本文的主要框架和内容,有些概念虽然没有在图中出现但在后文会提及。下图共分为三个部分,可以认为是计算机编码的三个发展阶段。先介绍第一阶段:ASCII
2. ASCII
 第一阶段:ASCII
1967年,美国国家标准学会(American National Standard Institute , ANSI)制定了一套基于拉丁字母的电脑编码方案,称为美国信息交换标准代码(American Standard Code for Information Interchange, ASCII) 。最开始编码的字符很少,数字、字母加上不可见的字符一共才定义了128 个。由于计算机中1字节=8位,为了存储和计算方便,ASCII编码使用一字节中的低7位来存储128个编码,最高位设置为0 。ASCII中共有2^7=128个字符,其中包括33个控制字符(不可见)和95个可见字符,看一张ASCII编码示意表:
 ASCII编码示意表
由上表可以看到,0-31和第127个字符属于控制字符(不可显示字符) ,其他都是可显示字符。其中48-57是0-9共10个阿拉伯数字,65-90为大写英文字母,97-122为小写英文字母 ,剩余字符是标点符号、运算符号等等。
最后一行被挡住的是“删除”
3. 扩展ASCII
 第二阶段:本土化--扩展ASCII
由于标准ASCII只使用了字节中的低7位,1981年,IBM对ASCII进行了扩充,它使用了字节中的最高位,共扩充了128个字符,这就是扩展ASCII(Extended ACII) 。扩展ASCII中0-127个字符和ASCII保持一致,第128-255位为扩展字符,扩展字符主要包括框线、音标和欧洲非英语系的一些字母。
虽然扩展ASCII是由IBM制定的,但是在某种程度上来说,目前所有的非ASCII码,都是对标准ASCII码的扩充 ,所以我在图中用大括号把下面所有的内容都包括了进去(包括第三阶段的内容)。从扩展ASCII开始,编码进入了第二个阶段:本土化
4.ISO 8859
随着世界各国计算机技术的发展,标准ASCII和扩展ASCII无法满足各种语言的需要,因此各个国家开始制定自己的文字编码,下图中列出了其中4种:ISO 8859,BIG5,Shift_JIS和GB系列编码。
 第二阶段:本土化--ISO 8859
先来介绍ISO 8859,ISO 8859也被称为ISO/IEC 8859 ,它是由国际标准化组织(International Organization for Standardization,ISO)和国际电工委员会(International Electrotechnical Commission,IEC)制定的一系列编码方案(也称字符集)。ISO 8859包括了15个针对不同语系的字符集 ,从ISO 8859-1到ISO 8859-16(ISO 8859-12未定义)。ISO 8859中每一个字符集都包括了128个ASCII字符和额外的128个字符 ,我们常见的是ISO 8859-1 ,也被称为Latin-1 ,主要包括了西欧常用字符,还包括德法两国的字母。
5. SBCS,DBCS和MBCS
上文提到的ASCII,扩展ASCII和ISO8859都是在单字节上进行编码的,因此它们都属于单字节字符集(Single-Byte Character Set,SBCS)。由于单字节字符集最多只能有2^8=256个位置可以使用,对于亚洲国家的字符来说是不够用的,所以逐渐出现了双字节字符集(Double-Byte CharacterSet, DBCS)、多字节字符集(Multi-Byte Character Set, MBCS)等。
 第二阶段:本土化--多字节字符集
上图列出的BIG5 是台湾地区繁体中文标准字符集 ,Shift_JIS 是日文标准字符集 ,这两个字符集都用单字节编码ASCII,用双字节编码汉字和日文 。用Python看一下两种编码方式的结果(麟的繁体字是麟,日文百度了一下貌似是りん,我也不知道)
#1. 使用BIG5-繁体字+英文
char_c = '麟'.encode('BIG5')
char_e = 'l'.encode('BIG5')
#1.1 打印编码
print(char_c) # b'\xc5\xef'
print(char_e) # b'l'
#1.2 打印编码后的数据类型
type(char_c) # <class 'bytes'>
type(char_e) # <class 'bytes'>
#1.3 打印字节长度
len(char_c) # 2
len(char_e) # 1
#2.使用Shift_JIS-日文+英文
char_j = 'りん'.encode('Shift_JIS')
char_e1 = 'l'.encode('Shift_JIS')
#2.1 打印编码
print(char_j) # b'\x82\xe8\x82\xf1'
print(char_e1) # b'l'
#2.2 打印编码后的数据类型
type(char_j) # <class 'bytes'>
type(char_e1) # <class 'bytes'>
#2.3 打印字节长度
len(char_j) # 4
len(char_e1) # 1
从代码结果可以看出,BIG5和Shift_JIS对于英文字母“l”使用一个字节编码,对于汉字和日文使用两个字节编码(日文中“麟”有2个字符所以字节长度是4,单字符的话字节长度还是2)。
6. GB2312,GBK和GB18030
6.1 GB2312
接下来着重介绍中文字符集的发展。GB2312-80 是第一个汉字编码国家标准,全称信息交换用汉字编码字符集 基本集(Code of Chinese Graphic Character Set for Information Interchange--Primary Set),由国家标准总局于1980年3月9日发布,1981年5月1日实施。GB 是国家标准(Guojia Biaozhun)的缩写。GB2312-80也被称作GB2312 ,共收录7445个字符,其中汉字6763个,拉丁字母、希腊字母、日本片假名等字符共682个。汉字包括一级汉字3755个和二级汉字3008个。
GB2312使用双字节对汉字编码,单字节对英文字符编码 。GB2312将所收录的字符进行分区处理,设定了94个区,每个区94个位 来存储字符,共有94*94=8836个位置,但并不是所有的位置都被填满。每一个字符都由一个区码和一个位码共同表示,这种表示方式也被称为区位码 。放一张GB2312字符表的示意图:
 GB2312区位码示意图
上图标红的数字就是区码,“横纵坐标”就是位码,例如第一个汉字“啊”的区位码就是1601。
GB2312使用两个字节对汉字进行编码,第一字节被称为区域字节或高字节,第二字节被称为位字节或低字节 。将每一个汉字的区码和位码分别加上0xA0就是这个汉字的GB2312编码(0x是十六进制标识符)。举例来说,“麟”在字符集中的区位码是8775 (查表得出),区码和位码转换成十六进制为0x57和0x4B,分别加上0xA0后结果为0xF7 和0xEB ,最终GB2312的编码就是0xF7EB 。使用代码验证一下:
#使用GB2312对汉字编码
char_c = '麟'.encode('GB2312')
char_e = 'l'.encode('GB2312')
#1. 打印编码
print(char_c) # b'\xf7\xeb'
print(char_e) # b'l'
#2. 打印编码后数据类型
type(char_c) # <class 'bytes'>
type(char_e) # <class 'bytes'>
#3. 打印字节长度
len(char_c) # 2
len(char_e) # 1
从代码中可以看到,汉字字符被编码后的字节长度为2,英文字母“l”被编码后字节长度为1。另外,这里的运算顺序不重要,先用87和75分别加160(0xA0)再转十六进制也可以。
6.2 GBK
GB2312收录的汉字可以满足日常生活中的用语,但是对于古汉语、人名中的罕见字和生僻字,还有繁体字都无法处理。所以在1995年12月,全国信息技术标准化技术委员会制订了汉字内码扩展规范(Chinese Internal Code Specification),也被简称为GBK(Guojia Biaozhun Kuozhan)。GBK对汉字采用双字节编码,对英文采用单字节编码,兼容ASCII和GB2312 。GBK共收录21886个符号,其中汉字有21003个,GBK将中文简体、繁体和日文都进行了扩充。
6.3 GB18030
随着国内少数民族对于计算机使用的增加,少数民族的文字也需要进行编码,2000年3月17日国家质量技术监督局推出了信息技术 信息交换用汉字编码字符集 基本集的扩充(Information Technology--Chinese Ideograms Coded Character Set for Information Interchange--Extension for the Basic Set, GB18030-2000),收录27533个汉字。2005年11月8日又发布了信息技术 中文编码字符集(Information Technology -- Chinese Coded Character Set, GB18030-2005/GB18030)。现行的是2005年发布的版本 ,2000年的版本已废止。
GB18030-2005覆盖中文、日文假名、朝鲜文和国内少数民族的文字等,共收录70244个汉字。同时,GB18030采用单字节、双字节和四字节三种方式对字符进行编码 。GB系列的字符集都可以在国家标准全文公开系统上查询到: http://openstd.samr.gov.cn/bzgk/gb/, GB18030向下兼容GBK,GB2312和ASCII 。
由于向下兼容,GB系列编码在对日常文字编码时结果都是相同的,上文代码中“麟”GB2312的编码结果是0xF7EB ,在Python中可以看到对“麟”使用GBK和GB18030编码的结果也是0xF7EB:
#1. 使用GBK对汉字编码
char_1 = '麟'.encode('GBK')
print(char_1) # b'\xf7\xeb'
#2. 使用GB18030对汉字编码
char_2 = '麟'.encode('GB18030')
print(char_2) # b'\xf7\xeb'
7. 代码页
7.1 代码页
在这里还要提出一个新的概念:代码页(Code Page) 。刚刚我们提到了4种编码方式,除去这些还有很多编码方式。当编码方式(或字符集)过多时,通过数字来标识各个字符集是一种方便的区分方法。代码页就是这种反映了数字和字符集之间映射关系的表 ,我们可以把它想象成一个目录。目前IBM,Microsoft,SAP,Oracle等公司都有自己的代码页,不同字符集在不同公司的代码页中被分配的页码不同 ,例如GBK在在IBM代码页被分配的ID为T1HK1114,在Windows代码页中为936。 IBM代码页 _https://www.ibm.com/support/knowledgecenter/SSLTBW_2.3.0/com.ibm.zos.v2r3.e0zx100/e0z2o00_codepagesoutlines.htm_ Windows代码页 _https://docs.microsoft.com/en-us/windows/win32/intl/code-page-identifiers_
还有一个问题,在Windows代码页中,ID 936对应的名称其实是gb2312 ,但是我在网上查了一圈大家都默认936就是gbk。我只能合理猜测由于GBK兼容GB2312且包含更多字符,所以936对应的字符集写的是gb2312实际却是gbk 另外,因为Code Page的缩写是CP ,GBK也经常被称为CP936 。
 Windows代码页中936=gb2312
7.2 ANSI
上图我们发现了另外两个单词:ANSI 和OEM 。其实这是ANSI Code Page 和OEM Code Page 的简写,这两个代码页是目前Windows系统使用的两种代码页。
先说ANSI,有没有感觉很熟悉在文章第2节,ASCII就是由ANSI(美国国家标准学会)制订的,ANSI是一个非营利性质的团体,负责制订各界的标准化文件,我们提到的字符集只是标准化文件中的一种。网上很多帖子都把ANSI当作一种字符编码的方式,导致我在最开始研究这些的时候经常搞错,其实网上说的ANSI应该叫做ANSI Code Page,官方称作Windows Code Page, 就是我们刚刚提到的Windows代码页。
而且,ANSI Code Page也属于误称,之前在Windows Code Page中使用最广泛的字符集叫做windows-1252 ,这个字符集是根据ANSI草案(ANSI Draft)拟定的,ANSI草案后来发展成为了ISO 8859-1(第4节)。由于windows-1252符合ANSI草案中的标准,所以很多人就用ANSI编码(ANSI Encoding)代指windows-1252,后来又将这个概念拓展了一下,认为Windows Code Page中所有的字符集都是符合ANSI标准的,所以就直接用ANSI Code Page代替了Windows Code Page。其实这是错误的,在Windows Code Page也有一些不符合ANSI标准的字符集 。但是由于这种叫法太过普遍,后来微软官方也就承认了ANSI Code Page=Windows Code Page 的说法。
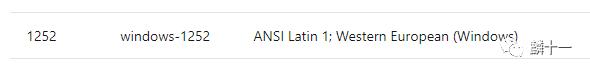
Windows代码页中1252=windows-1252
7.3 OEM
刚刚提到的ANSI Code Page基于图形用户界面,OEM Code Page应用于字符模式,也就是命令行界面 。最初设计OEM Code Page是为了向后兼容 ,也就是为了用户在使用Windows新的图形用户界面系统时也可以使用旧的命令行程序系统。
7.4 本地编码
还有一点,很多帖子中不仅会把ANSI当作一种编码方式,还会将它称为本地编码 。这种说法并不错误, 但其实本地编码的概念和Windows Code Page有关,不是ANSI。
Windows Code Page也被称为激活代码页(Active Code Page)或系统激活代码页(System Active Code Page) 。在一个Windows操作系统中,有且只有一个被激活的代码页(Active Windows Code Page)存在。简单来说就是一个操作系统当前只能使用一种编码方式 。这也很好理解,使用GBK字符集的时候无法打印出其他字符集中的字符,因为系统当前只激活了GBK的编码方式。
每一个Windows系统中都有语言设置,被激活的字符集和操作系统的语言总是保持一致,所以会被称作本地编码 。每一种语言设置都有一个默认使用的字符集,例如简体中文操作系统的默认字符集为GBK,繁体中文系统为BIG5,日文系统为Shift_JIS等。所以说,本地编码指的是Windows当前被激活的代码页所使用的字符集 (如果不做任何改动,就使用默认字符集)。被激活的代码页Active Code Page又被称为Windows Code Page,而Windows Code Page又被误称为ANSI Code Page或ANSI,所以ANSI就被认为是本地编码了
目前在Windows系统中对文件进行编码时,会出现“ANSI”选项,这里ANSI就代表了系统当前语言的默认编码方式,在11.3节中会有图示。有关代码页的内容在微软官网上有相关说明,网址是 _https://docs.microsoft.com/en-us/windows/win32/intl/code-pages?redirectedfrom=MSDN_
这部分的最后,贴一个Windows系统中查询默认编码方式的方法,非常简单,在命令提示符界面输入chcp 。我的系统是简体中文系统,下图可以看到代码页是936,也就是前文说的GBK(CP936)。
WIndows系统查询代码页
以上就是字符编码的第一阶段和第二阶段,下一篇开始进入全球化阶段~
~END~