Skip to content

Backpropagation ​

Backpropagation(反向传播),就是告诉我们用gradient descent来train一个neural network的时候该怎么做,它只是求微分的一种方法,而不是一种新的算法

Gradient Descent ​

gradient descent的使用方法,跟前面讲到的linear Regression或者是Logistic Regression是一模一样的,唯一的区别就在于当它用在neural network的时候,network parameters θ=w1,w2,...,b1,b2,...里面可能会有将近million个参数

所以现在最大的困难是,如何有效地把这个近百万维的vector给计算出来,这就是Backpropagation要做的事情,所以Backpropagation并不是一个和gradient descent不同的training的方法,它就是gradient descent,它只是一个比较有效率的算法,让你在计算这个gradient的vector的时候更有效率

Chain Rule ​

Backpropagation里面并没有什么高深的数学,你唯一需要记得的就只有Chain Rule(链式法则)

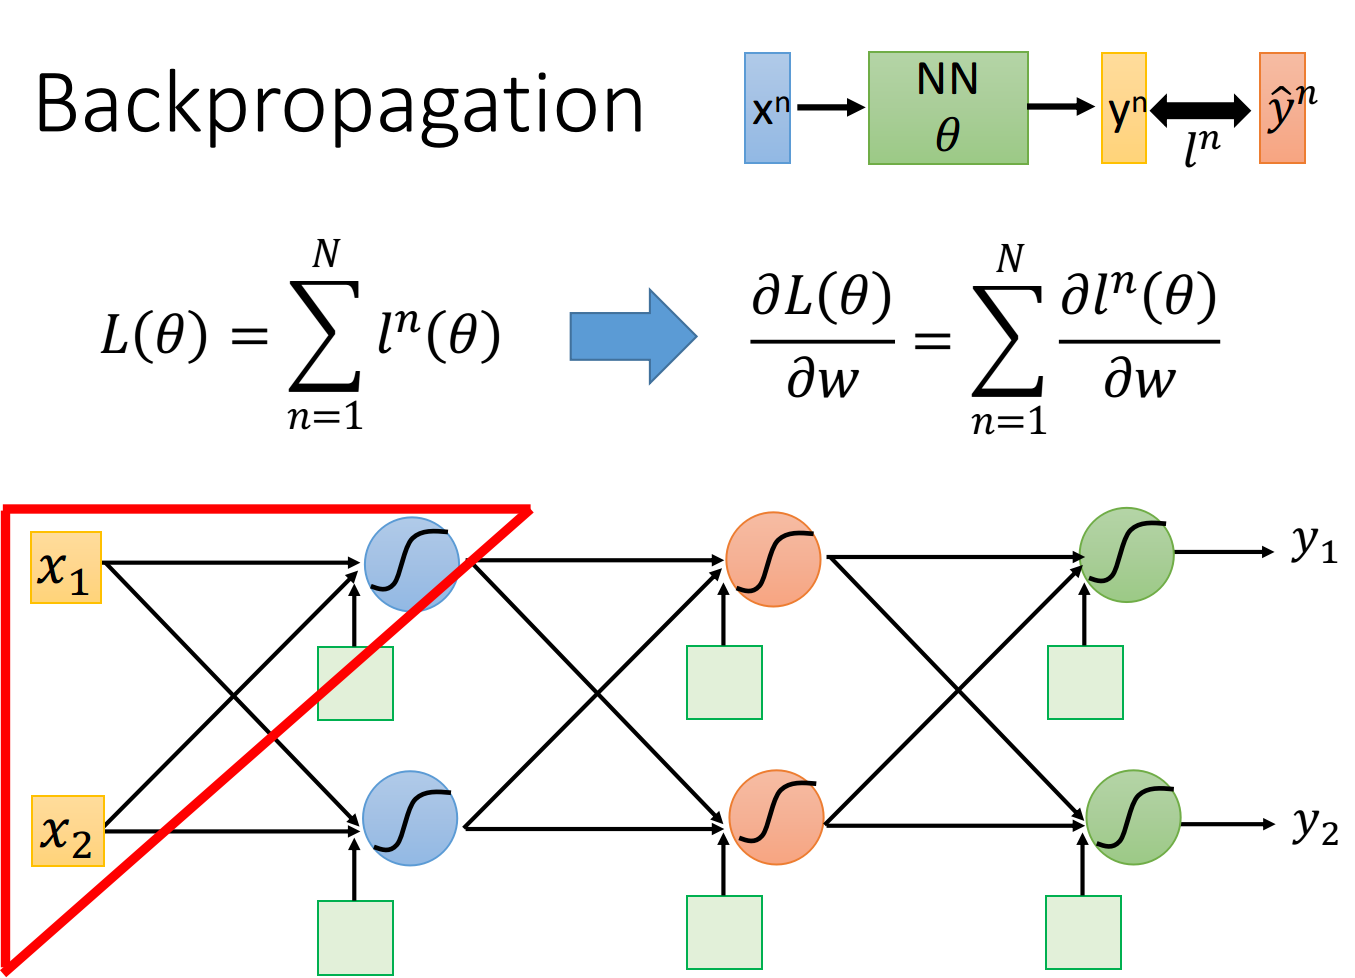
对整个neural network,我们定义了一个loss function:L(θ)=∑n=1Nln(θ),它等于所有training data的loss之和

我们把training data里任意一个样本点xn代到neural network里面,它会output一个yn,我们把这个output跟样本点本身的label标注的target y^n作cross entropy,这个交叉熵定义了output yn和target y^n之间的距离ln(θ),如果cross entropy比较大的话,说明output和target之间距离很远,这个network的parameter的loss是比较大的,反之则说明这组parameter是比较好的

然后summation over所有training data的cross entropy ln(θ),得到total loss L(θ),这就是我们的loss function,用这个L(θ)对某一个参数w做偏微分,表达式如下:

∂L(θ)∂w=∑n=1N∂ln(θ)∂w

这个表达式告诉我们,只需要考虑如何计算对某一笔data的∂ln(θ)∂w,再将所有training data的cross entropy对参数w的偏微分累计求和,就可以把total loss对某一个参数w的偏微分给计算出来

我们先考虑某一个neuron,先拿出上图中被红色三角形圈住的neuron,假设只有两个input x1,x2,通过这个neuron,我们先得到z=b+w1x1+w2x2,然后经过activation function从这个neuron中output出来,作为后续neuron的input,再经过了非常非常多的事情以后,会得到最终的output y1,y2

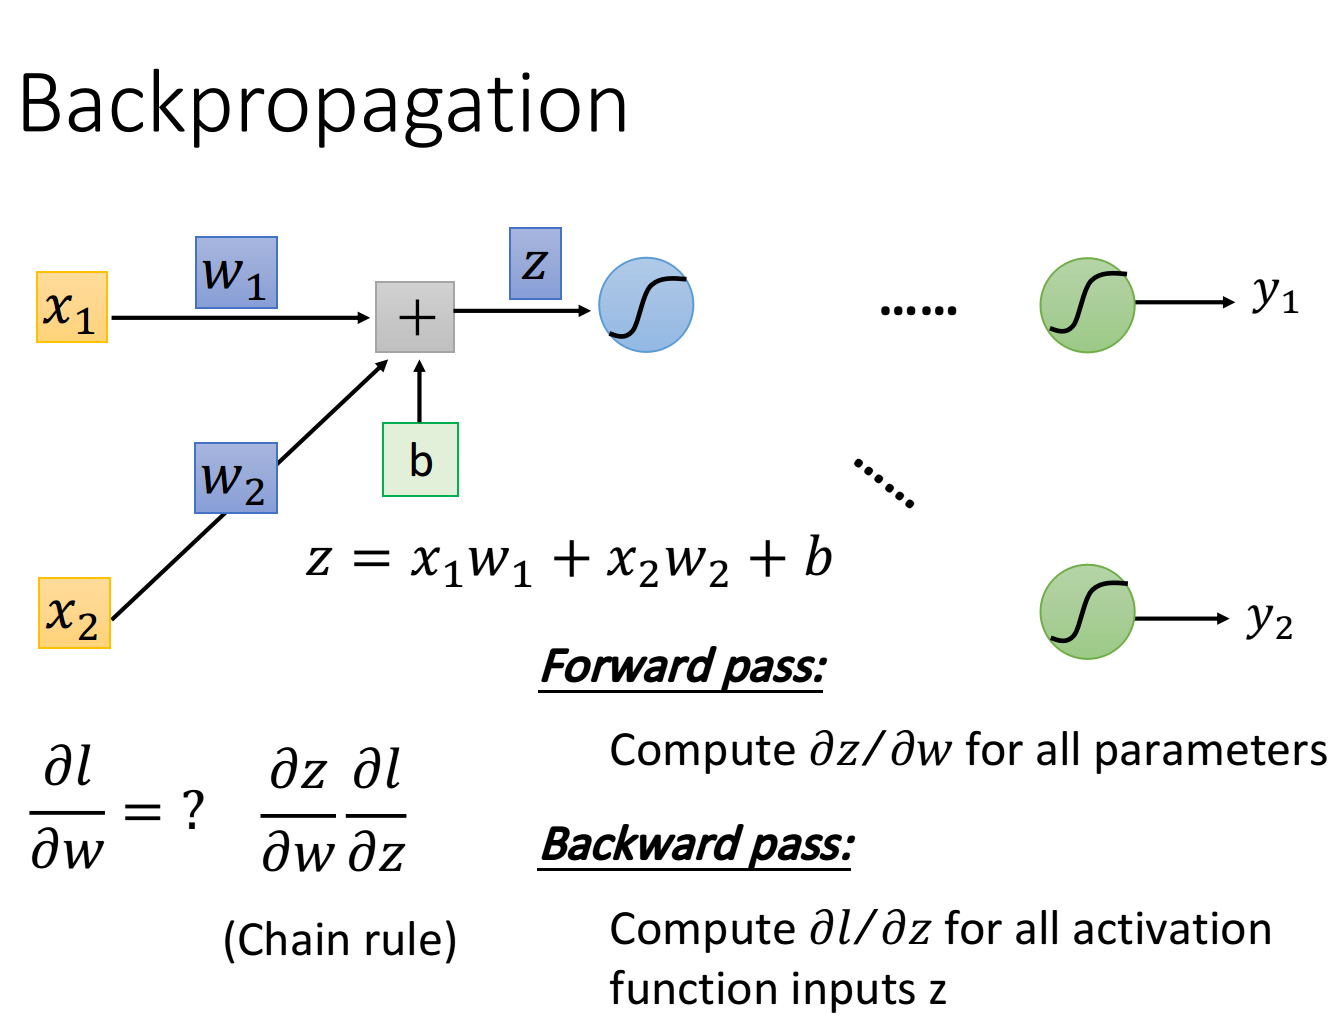
现在的问题是这样:∂l∂w该怎么算?按照chain rule,可以把它拆分成两项,∂l∂w=∂z∂w∂l∂z,这两项分别去把它计算出来。前面这一项是比较简单的,后面这一项是比较复杂的

计算前面这一项∂z∂w的这个process,我们称之为Forward pass;而计算后面这项∂l∂z的process,我们称之为Backward pass

Forward pass ​

先考虑∂z∂w这一项,完全可以秒算出来,∂z∂w1=x1, ∂z∂w2=x2

它的规律是这样的:==求∂z∂w,就是看w前面连接的input是什么,那微分后的∂z∂w值就是什么==,因此只要计算出neural network里面每一个neuron的output就可以知道任意的z对w的偏微分

  • 比如input layer作为neuron的输入时,w1前面连接的是x1,所以微分值就是x1;w2前面连接的是x2,所以微分值就是x2
  • 比如hidden layer作为neuron的输入时,那该neuron的input就是前一层neuron的output,于是∂z∂w的值就是前一层的z经过activation function之后输出的值(下图中的数据是假定activation function为sigmoid function得到的)

Backward pass ​

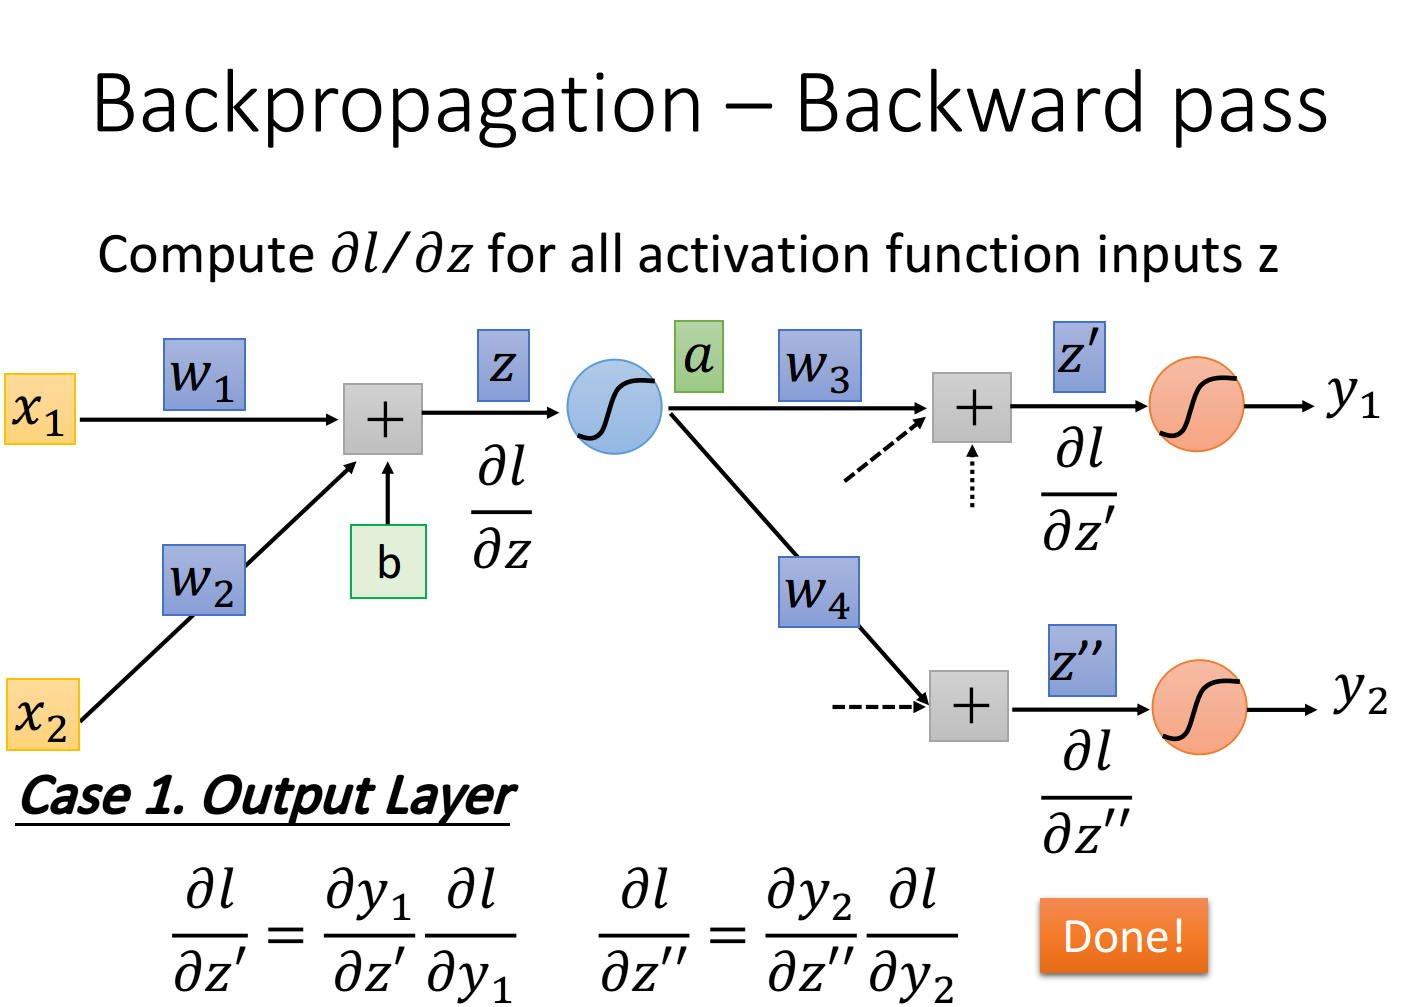
再考虑∂l∂z这一项,它是比较复杂的,这里我们依旧假设activation function是sigmoid function

公式推导 ​

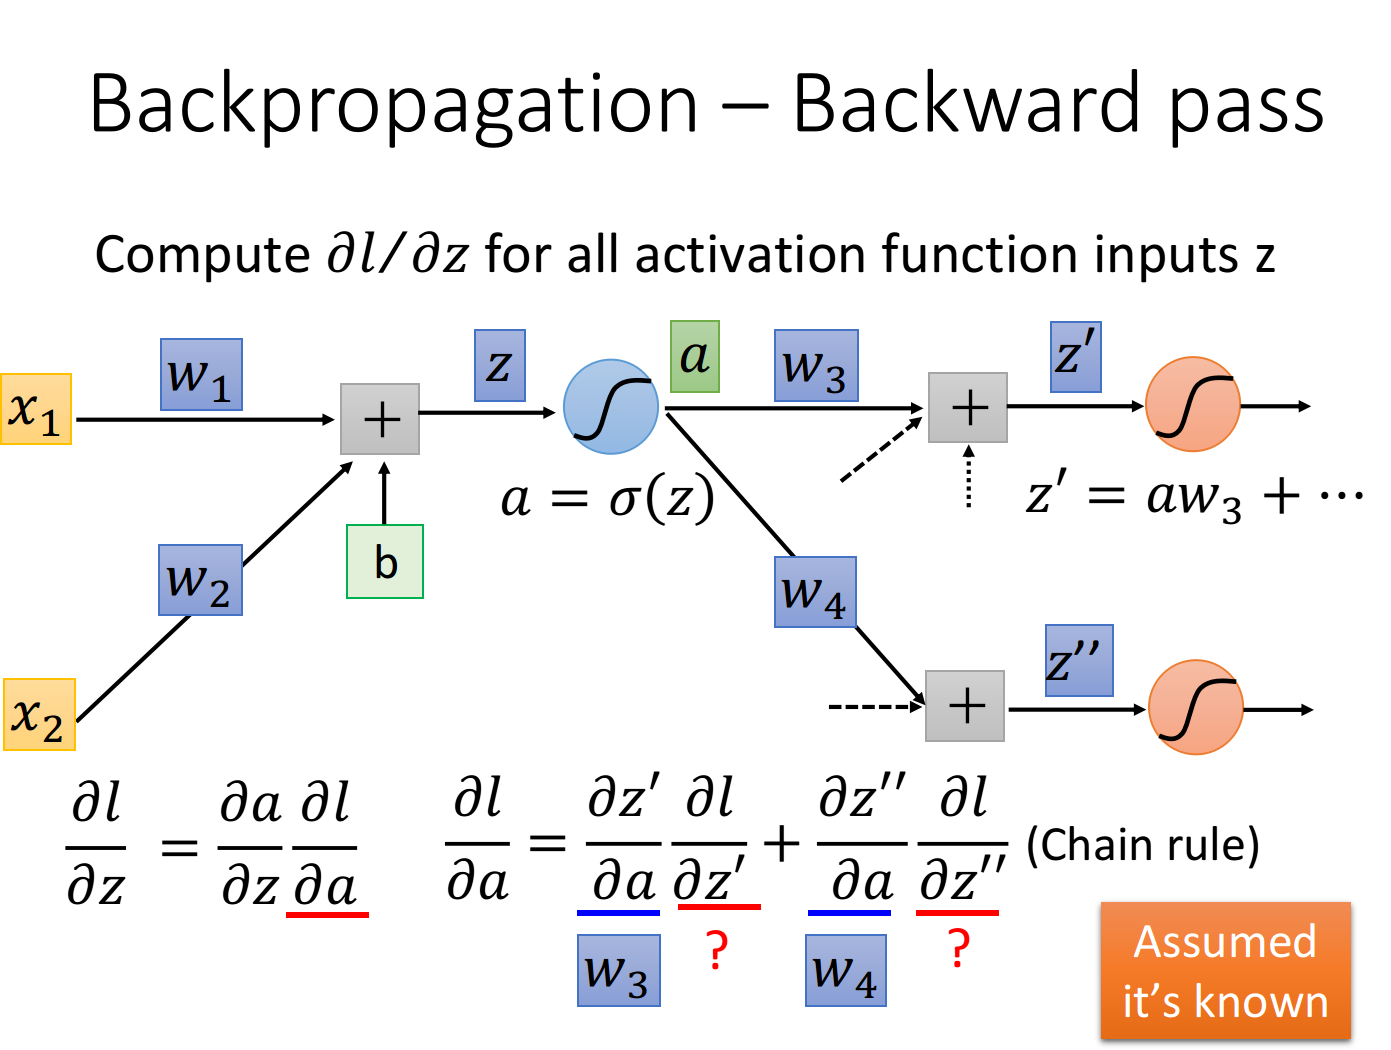
我们的z通过activation function得到a,这个neuron的output是a=σ(z),接下来这个a会乘上某一个weight w3,再加上其它一大堆的value得到z′,它是下一个neuron activation function的input,然后a又会乘上另一个weight w4,再加上其它一堆value得到z″,后面还会发生很多很多其他事情,不过这里我们就只先考虑下一步会发生什么事情:

∂l∂z=∂a∂z∂l∂a

这里的∂a∂z实际上就是activation function的微分(在这里就是sigmoid function的微分),接下来的问题是∂l∂a应该长什么样子呢?a会影响z′和z″,而z′和z″会影响l,所以通过chain rule可以得到

∂l∂a=∂z′∂a∂l∂z′+∂z″∂a∂l∂z″

这里的∂z′∂a=w3,∂z″∂a=w4,那∂l∂z′和∂l∂z″又该怎么算呢?这里先假设我们已经通过某种方法把∂l∂z′和∂l∂z″这两项给算出来了,然后回过头去就可以把∂l∂z给轻易地算出来

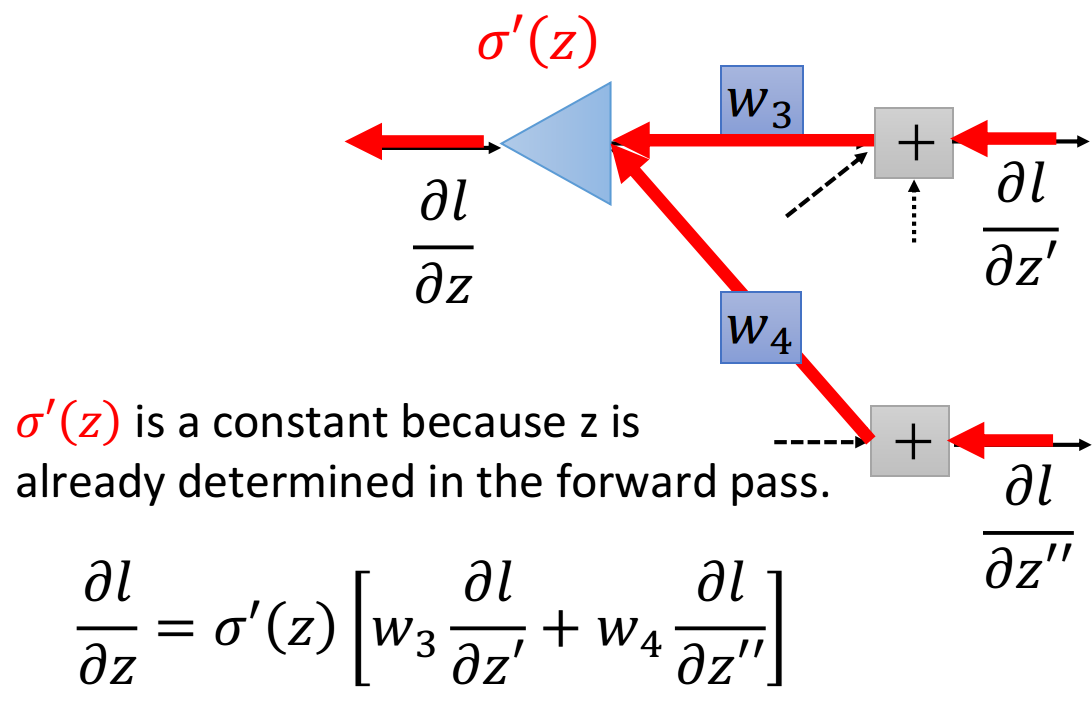
∂l∂z=∂a∂z∂l∂a=σ′(z)[w3∂l∂z′+w4∂l∂z″]

另一个观点 ​

这个式子还是蛮简单的,然后,我们可以从另外一个观点来看待这个式子

你可以想象说,现在有另外一个neuron,它不在我们原来的network里面,在下图中它被画成三角形,这个neuron的input就是∂l∂z′和∂l∂z″,那input ∂l∂z′就乘上w3,input ∂l∂z″就乘上w4,它们两个相加再乘上activation function的微分 σ′(z),就可以得到output ∂l∂z

这张图描述了一个新的“neuron”,它的含义跟图下方的表达式是一模一样的,作这张图的目的是为了方便理解

值得注意的是,这里的σ′(z)是一个constant常数,它并不是一个function,因为z其实在计算forward pass的时候就已经被决定好了,z是一个固定的值

所以这个neuron其实跟我们之前看到的sigmoid function是不一样的,它并不是把input通过一个non-linear进行转换,而是直接把input乘上一个constant σ′(z),就得到了output,因此这个neuron被画成三角形,代表它跟我们之前看到的圆形的neuron的运作方式是不一样的,它是直接乘上一个constant(这里的三角形有点像电路里的运算放大器op-amp,它也是乘上一个constant)

两种情况 ​

ok,现在我们最后需要解决的问题是,怎么计算∂l∂z′和∂l∂z″这两项,假设有两个不同的case:

case 1:Output Layer ​

假设蓝色的这个neuron已经是hidden layer的最后一层了,也就是说连接在z′和z″后的这两个红色的neuron已经是output layer,它的output就已经是整个network的output了,这个时候计算就比较简单

∂l∂z′=∂y1∂z′∂l∂y1

其中∂y1∂z′就是output layer的activation function (softmax) 对z′的偏微分

而∂l∂y1就是loss对y1的偏微分,它取决于你的loss function是怎么定义的,也就是你的output和target之间是怎么evaluate的,你可以用cross entropy,也可以用mean square error,用不同的定义,∂l∂y1的值就不一样

这个时候,你就已经可以把l对w1和w2的偏微分∂l∂w1、∂l∂w2算出来了

Case 2:Not Output Layer ​

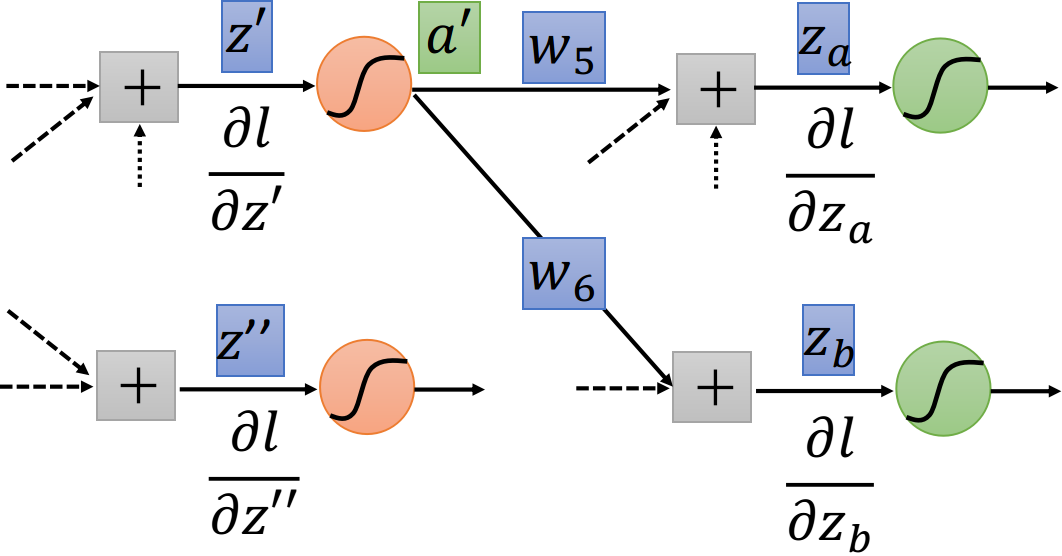
假设现在红色的neuron并不是整个network的output,那z′经过红色neuron的activation function得到a′,然后output a′和w5、w6相乘并加上一堆其他东西分别得到za和zb,如下图所示

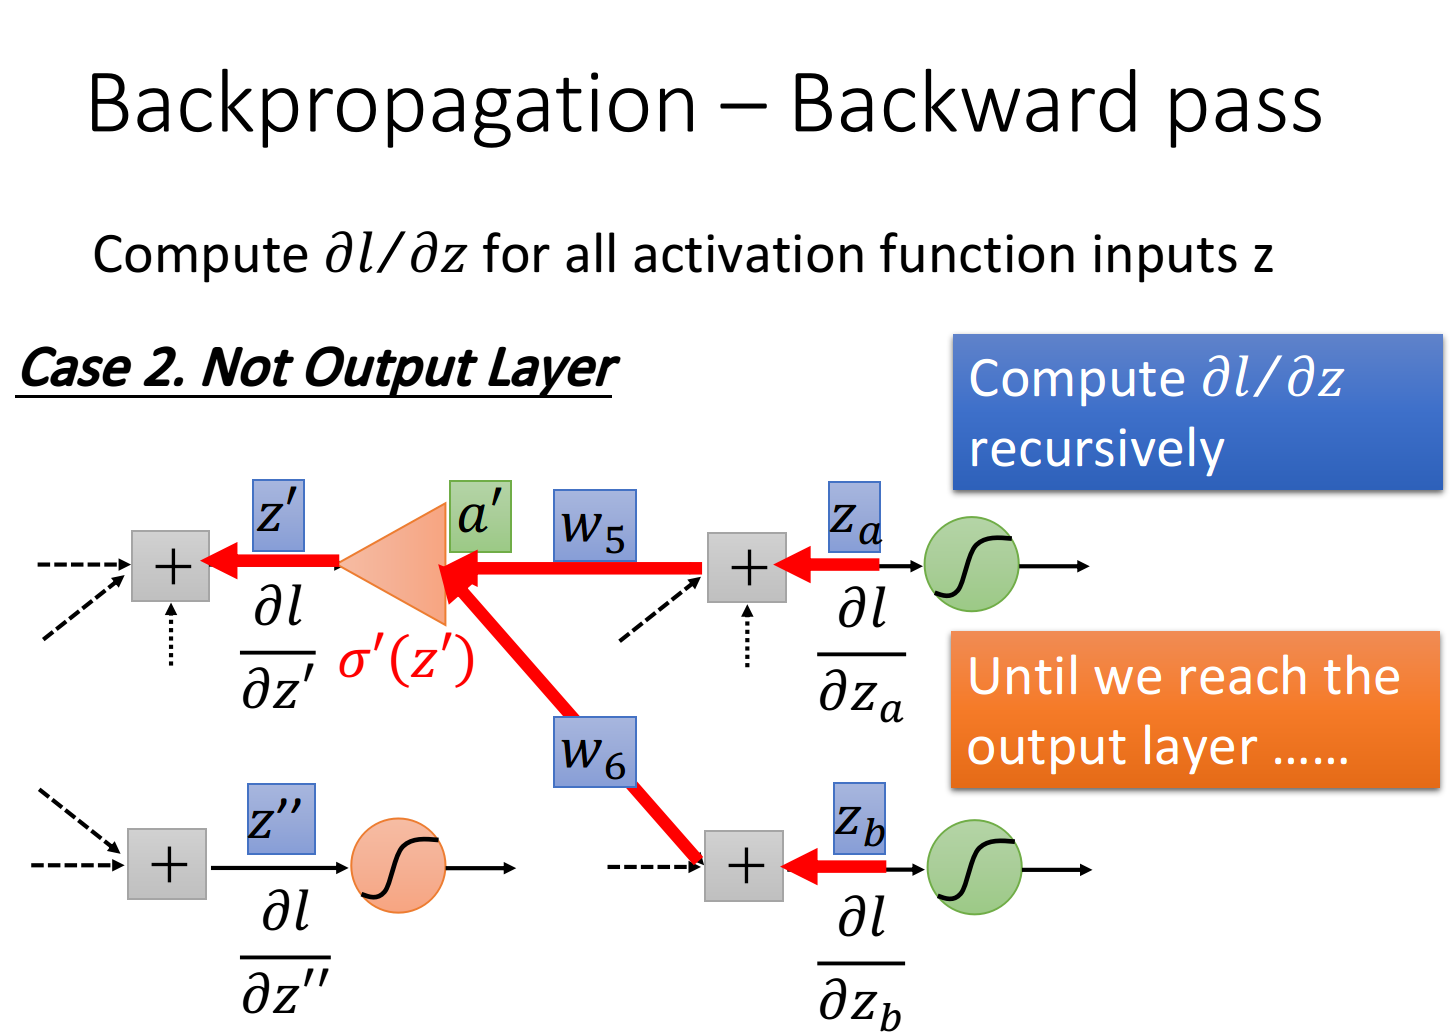
根据之前的推导证明类比,如果知道∂l∂za和∂l∂zb,我们就可以计算∂l∂z′,如下图所示,借助运算放大器的辅助理解,将∂l∂za乘上w5和∂l∂zb乘上w6的值加起来再通过op-amp,乘上放大系数σ′(z′),就可以得到output ∂l∂z′

∂l∂z′=σ′(z′)[w5∂l∂za+w6∂l∂zb]

知道z′和z″就可以知道z,知道za和zb就可以知道z′,...... ,现在这个过程就可以反复进行下去,直到找到output layer,我们可以算出确切的值,然后再一层一层反推回去

你可能会想说,这个方法听起来挺让人崩溃的,每次要算一个微分的值,都要一路往后走,一直走到network的output,如果写成表达式的话,一层一层往后展开,感觉会是一个很可怕的式子,但是!实际上并不是这个样子做的

你只要换一个方向,从output layer的∂l∂z开始算,你就会发现它的运算量跟原来的network的Feedforward path其实是一样的

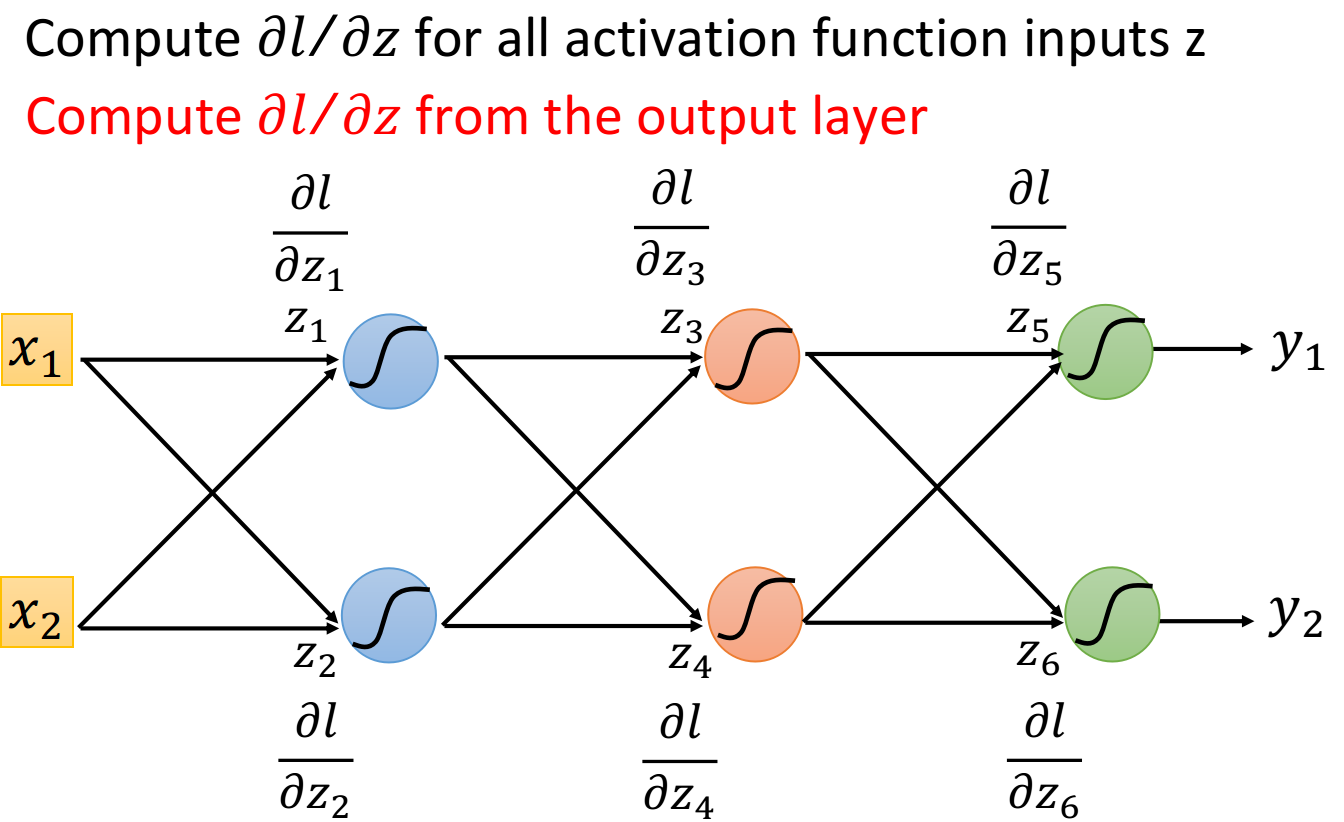
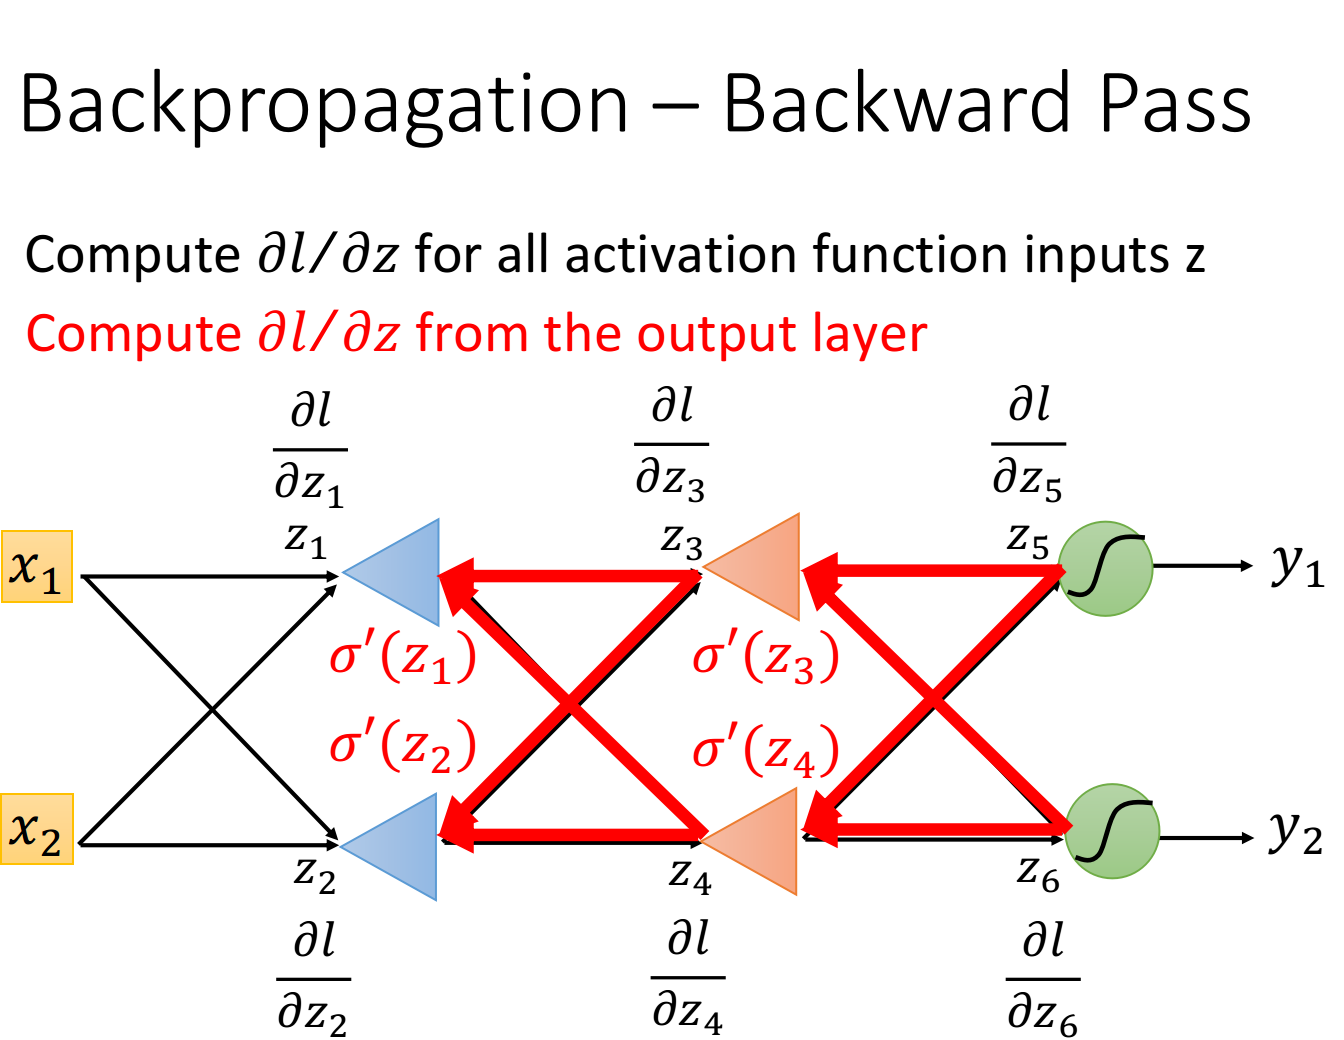
假设现在有6个neuron,每一个neuron的activation function的input分别是z1、z2、z3、z4、z5、z6,我们要计算l对这些z的偏微分,按照原来的思路,我们想要知道z1的偏微分,就要去算z3和z4的偏微分,想要知道z3和z4的偏微分,就又要去计算两遍z5和z6的偏微分,因此如果我们是从z1、z2的偏微分开始算,那就没有效率

但是,如果你反过来先去计算z5和z6的偏微分的话,这个process,就突然之间变得有效率起来了,我们先去计算∂l∂z5和∂l∂z6,然后就可以算出∂l∂z3和∂l∂z4,最后就可以算出∂l∂z1和∂l∂z2,而这一整个过程,就可以转化为op-amp运算放大器的那张图

这里每一个op-amp的放大系数就是σ′(z1)、σ′(z2)、σ′(z3)、σ′(z4),所以整一个流程就是,先快速地计算出∂l∂z5和∂l∂z6,然后再把这两个偏微分的值乘上路径上的weight汇集到neuron上面,再通过op-amp的放大,就可以得到∂l∂z3和∂l∂z4这两个偏微分的值,再让它们乘上一些weight,并且通过一个op-amp,就得到∂l∂z1和∂l∂z2这两个偏微分的值,这样就计算完了,这个步骤,就叫做Backward pass

在做Backward pass的时候,实际上的做法就是建另外一个neural network,本来正向neural network里面的activation function都是sigmoid function,而现在计算Backward pass的时候,就是建一个反向的neural network,它的activation function就是一个运算放大器op-amp,每一个反向neuron的input是loss l对后面一层layer的z的偏微分∂l∂z,output则是loss l对这个neuron的z的偏微分∂l∂z,做Backward pass就是通过这样一个反向neural network的运算,把loss l对每一个neuron的z的偏微分∂l∂z都给算出来

注:如果是正向做Backward pass的话,实际上每次计算一个∂l∂z,就需要把该neuron后面所有的∂l∂z都给计算一遍,会造成很多不必要的重复运算,如果写成code的形式,就相当于调用了很多次重复的函数;而如果是反向做Backward pass,实际上就是把这些调用函数的过程都变成调用“值”的过程,因此可以直接计算出结果,而不需要占用过多的堆栈空间

Summary ​

最后,我们来总结一下Backpropagation是怎么做的

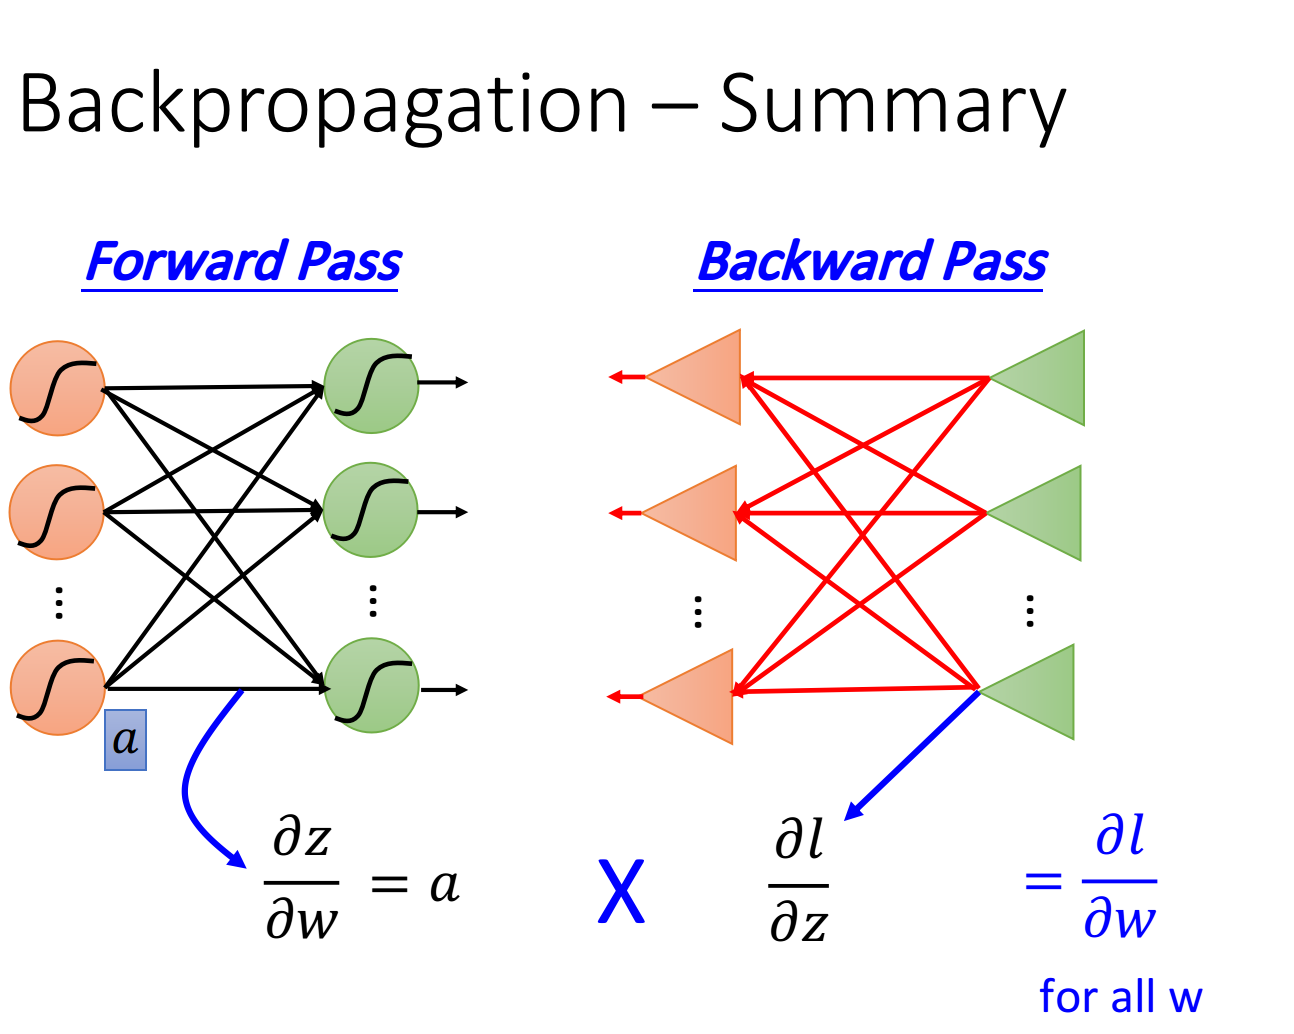
Forward pass,每个neuron的activation function的output,就是它所连接的weight的∂z∂w

Backward pass,建一个与原来方向相反的neural network,它的三角形neuron的output就是∂l∂z

把通过forward pass得到的∂z∂w和通过backward pass得到的∂l∂z乘起来就可以得到l对w的偏微分∂l∂w

∂l∂w=∂z∂w|forward pass⋅∂l∂z|backward pass